BLOG · 第 7 / 15 页
VOLCENGING 博客
探索前沿技术,分享实践经验,追踪行业动态。237 篇技术文章与行业观察,图片与排版全部在本站重建。
237 篇文章
15 页分页
9 类主题徽章
POSTS · 本页 16 篇
全部文章 · 第 7 页
按源站发布时间倒序排列,徽章为主题分类。当前第 7 页,共 15 页。
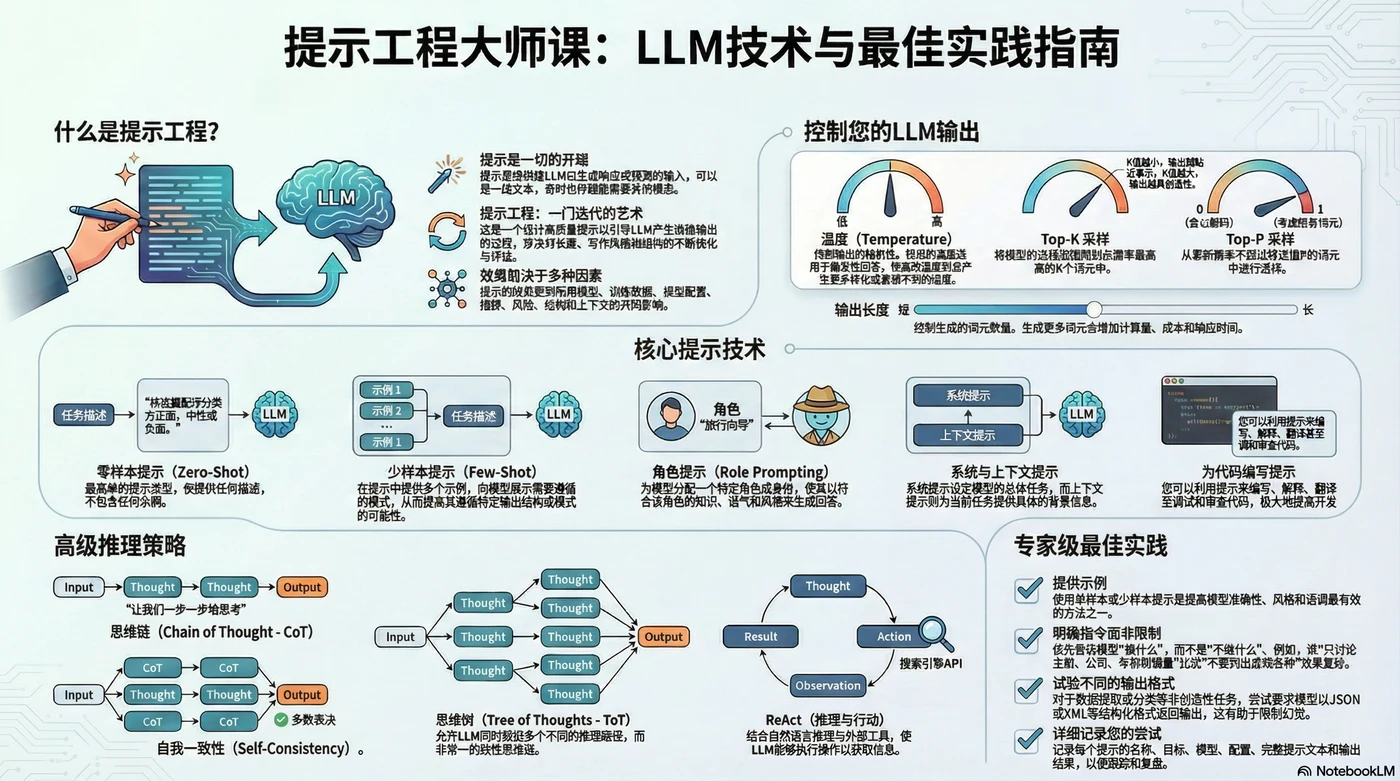 点石成金:5 个让你大开眼界的 AI 提示技巧,彻底释放模型的真正潜力你是否也曾有过这样的经历:满怀期待地向功能强大的人工智能(AI)模型提问,却只得到一些平庸、泛泛、甚至不着边际的回答?这确实令人沮丧。我们不禁会问,这些被誉为“革命性”的技术,潜力究竟在哪里? 其实,决定 AI 输出质量的关键,往往不在于 AI 本身,而在于我们的提问方式——这门艺术与科学被称为“阅读全文
更多文章
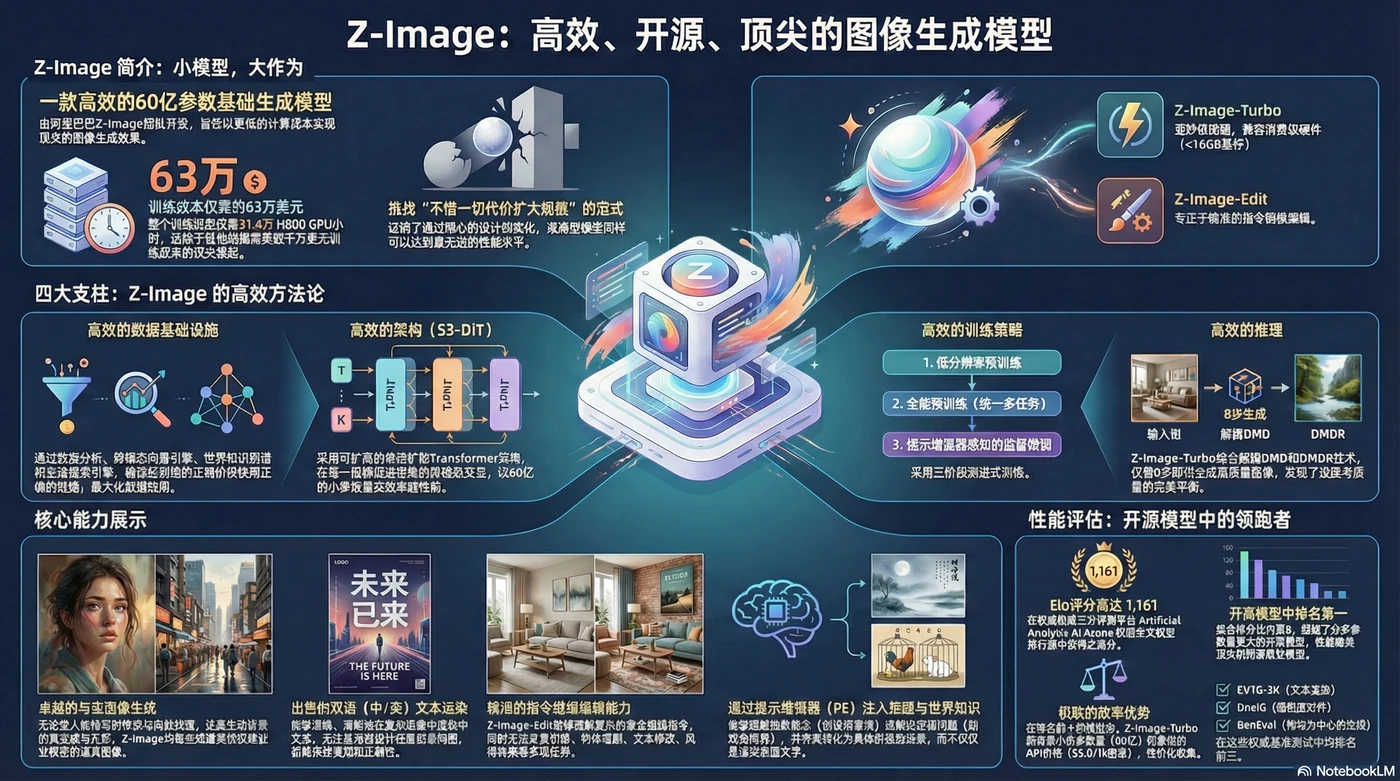 Z-Image 技术白皮书:高效单流扩散 Transformer 赋能新一代图像生成摘要与引言 近年来,文本到图像(Text-to-Image, T2I)生成技术取得了革命性进展,然而,其发展也面临两大严峻挑战。一方面,性能最顶尖的模型,如 Nano Banana Pro 与 Seedream 4.0,多为不透明的…阅读全文
 Dolphin-v2:拍照论文也能实现精准解析Dolphin-v2 是 ByteDance 最新发布的文档解析模型,有一个功能打破了我的惯性认知:它对拍照生成的文档,比数字文档更重视整体页面的结构。 这并不是偶然。多数模型处理拍照文档时容易受扭曲、光影干扰的影响,只能提取片段式…阅读全文
 Qwen3-VL:引领多模态交互新范式多模态不只是图文拼贴 市面上号称“理解图像 + 对话”的模型不少,但能真正在产品中接管操作、进行图形编程、面向任务完成交互的,多数仍停留在演示层面。Qwen3-VL-235B-A22B-Thinking,来自通义千问团队,是一款不太…阅读全文
 GLM-4.6V:重塑多模态智能新范式GLM-4.6V 是智谱 AI 最新发布的多模态大模型,兼具高性能与实用性,彻底刷新了对视觉语言模型的期待。 模型架构与亮点 GLM-4.6V 系列包括两个版本:GLM-4.6V(106B)面向云端与大集群,GLM-4.6V-Fla…阅读全文
 给 TRAE SOLO 一台服务器,它能干什么?前一阵子刷到一个很有意思的操作:有人直接把一台服务器的权限扔给了 AI,并简单说了句目标。 然后,AI 就从零开始安装环境、配依赖,拉仓库,启动服务,最后成功完成了对外服务的提供。 今天,我们就尝试下这个思路:让 TRAE SOLO…阅读全文
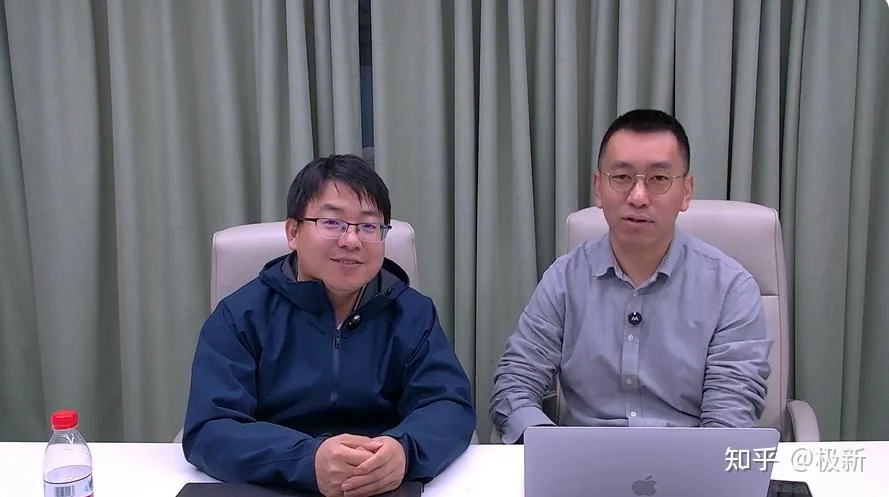 对话 VOLCENGING 联合创始人王鹏:用闲时算力共享撬动 AI 未来 | 极新直播实录科技新鲜事,尽在掌握 当 AI 推理需求从实验室走向产业应用,算力供给方式正在经历一场静默革命:个人电脑秒变计算节点、网吧夜间闲置资源被激活、云平台闲时算力被精准调度……在这场变革中,一家成立仅两年的创业公司如何用平台模式重构算力市…阅读全文
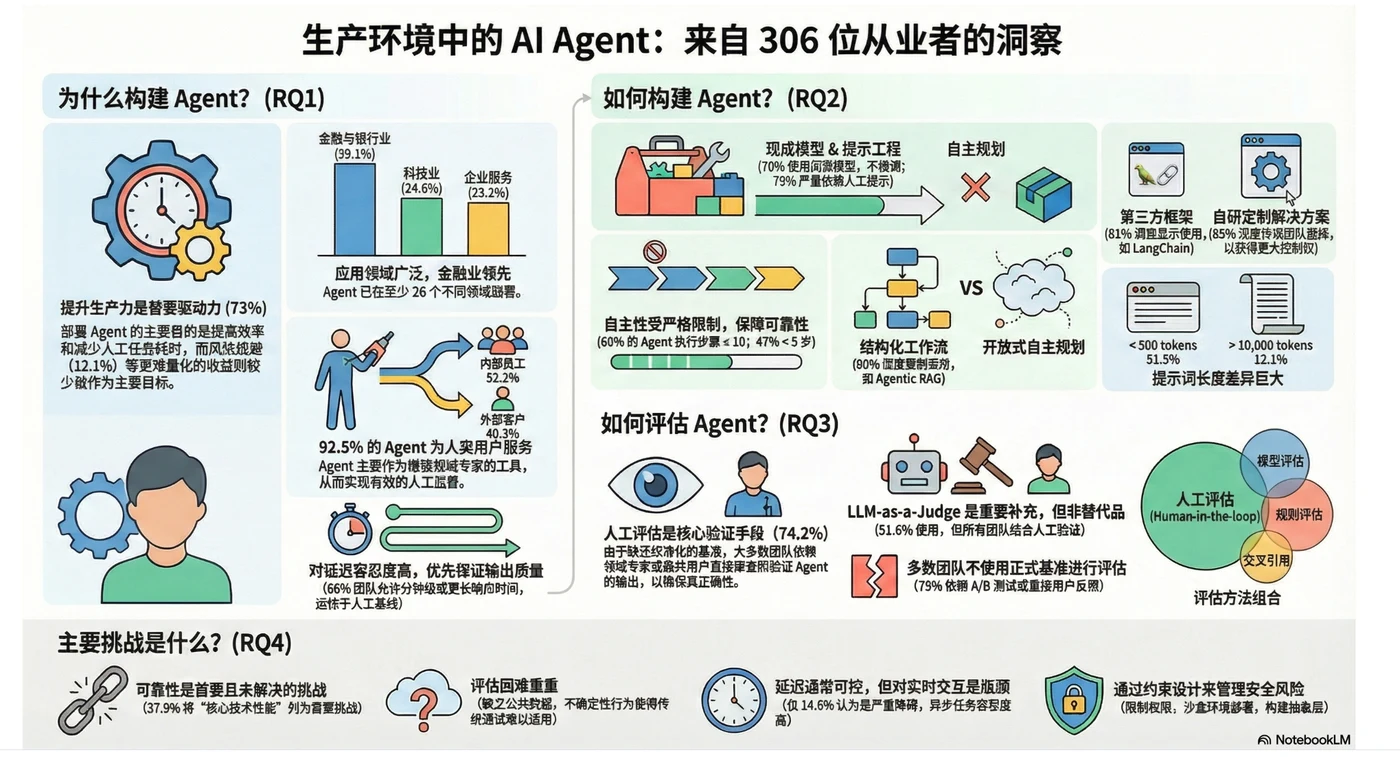 AI 智能体浪潮的背后:揭示生产环境中的 5 个意外真相深入现场:AI_智能体,究竟什么才有效?.mp4(/assets/Hdg6bsNOXoZBqCx3n1pcIPk9nzg.mp4) 从能够自主完成复杂任务的超级助理,到颠覆整个行业的自动化大军,关于 AI 智能体(AI Agent)…阅读全文
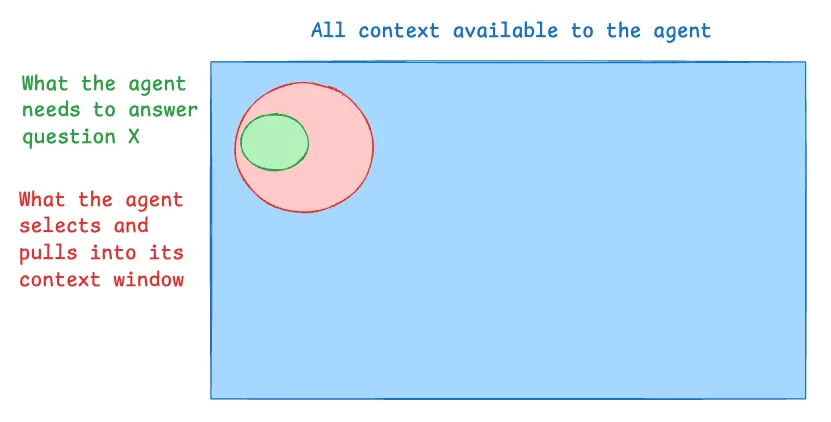 深度代理如何利用文件系统进行上下文工程深度代理的一个关键特性是它们能够访问一组文件系统工具。深度代理可以使用这些工具来读取、写入、编辑、列出并搜索文件系统中的文件。 在这篇文章中,我们将讲解为什么我们认为文件系统对代理来说很重要。为了理解文件系统为何有帮助,我们应先思考…阅读全文
 小模型,大革命:腾讯开源 HunyuanOCR 如何以 10 亿参数颠覆行业光学字符识别(OCR)技术早已渗透到我们工作和生活的方方面面,但传统的 OCR 方案往往像一个庞大而笨拙的工厂流水线,不仅部署复杂、维护成本高昂,而且环环相扣的流程极易导致错误累积,最终影响识别的准确性。现在,这一长期存在的挑战迎来…阅读全文
 Maya 多模态模型支持 8 国语言多模态与多语种同时进化 图像理解和语言生成的结合一直是 AI 研究的热点,但跨语种支持通常是短板。Maya 的出现正在改写这一常识,由 Cohere For AI Community 打造,这款模型不仅打通了视觉与语言,还能在八种语…阅读全文
 更小模型实现更强视觉 OCR专为真实图像优化的多语种 OCR NCSOFT 发布的 VARCO-VISION-2.0-1.7B-OCR,是当前视觉 OCR 模型里一个很值得关注的新成员。相较于那些动辄十几亿参数的多模态大家伙,这个模型只有 17 亿参数,但效果…阅读全文
 VARCO-VISION 轻量版打破端侧壁垒VARCO-VISION-2.0-1.7B 是少数在端侧部署仍保有强大视觉理解能力的模型之一。由 NCSOFT 发布,这个多模态模型支持图文混合输入,并具备多图推理与文本本地化 OCR,专为韩文优化,但在英文任务中依然表现不俗。用轻…阅读全文
 LLaVA-Onevision 支持图像到视频迁移图像模型首次懂视频 LLaVA-Onevision 是一种由 LLaVA 团队发布的新型多模态大模型,结合了 Qwen2 的语言理解能力和视觉对齐能力。 这套模型的独特之处在于,它既能处理单图、多图,又能自然迁移至视频理解场景。对开…阅读全文
 Idefics2 给多模态模型打了个翻身仗更小但更强的多模态利器 视觉语言模型赛道的惯性思维是,大就是强。打榜比拼中,MM1-30B、LLava-Next-34B 这些高参数巨兽长期霸榜。 然而 Hugging Face 推出的 Idefics2 推翻了这套逻辑:仅用 8B…阅读全文
 轻量多模态王者 LLaVAPhi3 mini 登场拆解轻量视觉模型的黑马 LLaVA-Phi-3-mini 是 XTuner 团队推出的一款多模态小模型,融合了 Microsoft 的 Phi-3-mini 和 OpenAI 的 CLIP-ViT-Large-patch14-336…阅读全文