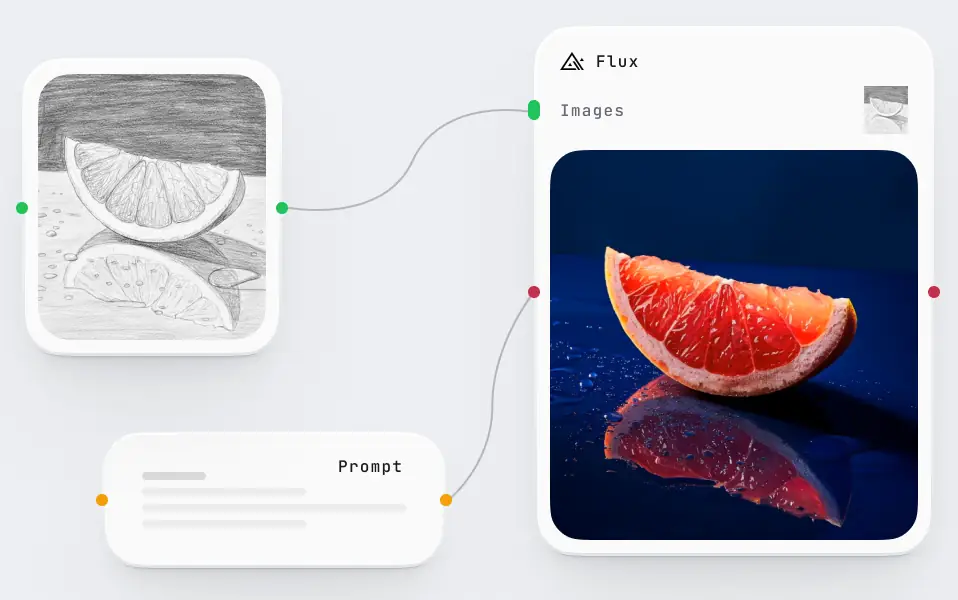
AI 图像创作
深度整合 Flux、Qwen Image、Z-image 模型,ComfyUI 工作流秒级响应,确保商业级品质输出
深度整合 Flux、Qwen Image、Z-image 模型,ComfyUI 工作流秒级响应,确保商业级品质输出
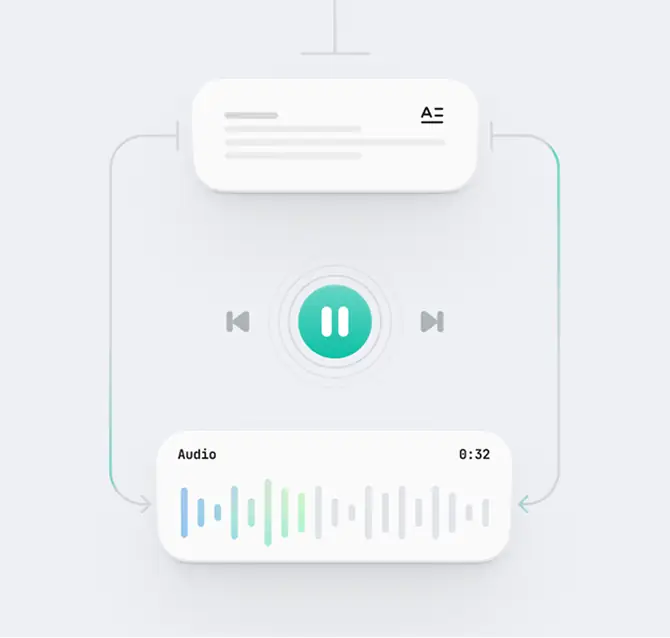
支持模型 IndexTTS,具备零样本声音克隆等先进功能,适用于教育、创作等多种场景
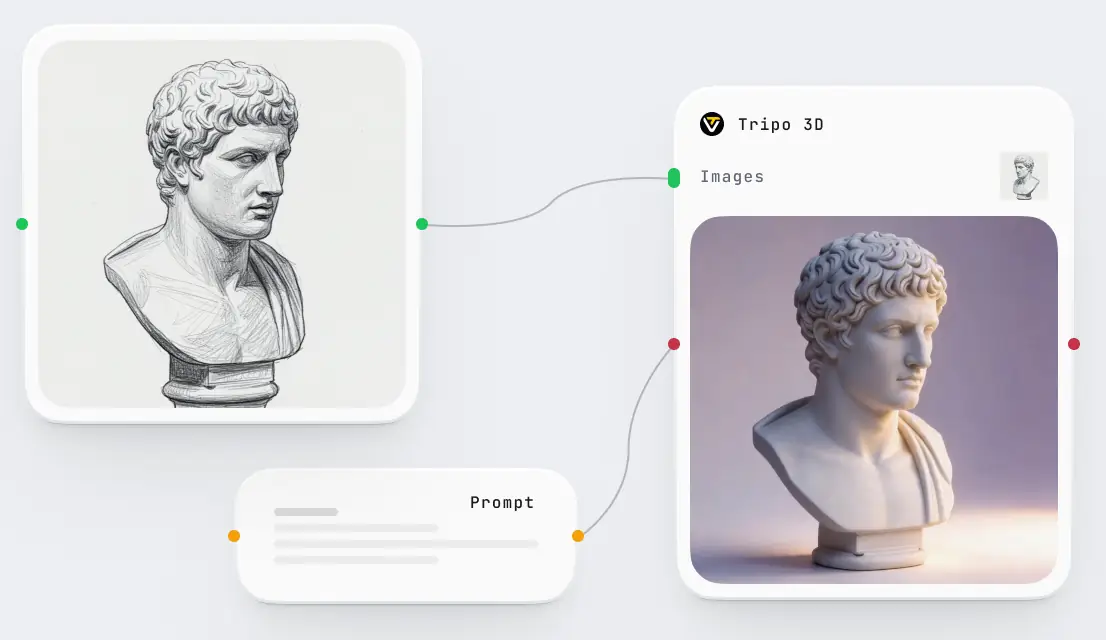
支持模型 HunyuanWorld-Mirror,通过文本、图像或涂鸦,十秒内生成专业级 3D 模型,适用于游戏开发、产品设计和元宇宙应用
支持模型 YuE、MusicGen,文本与歌词生成完整歌曲,支持曲风控制与旋律续写,适用于短视频配乐、游戏音轨创作
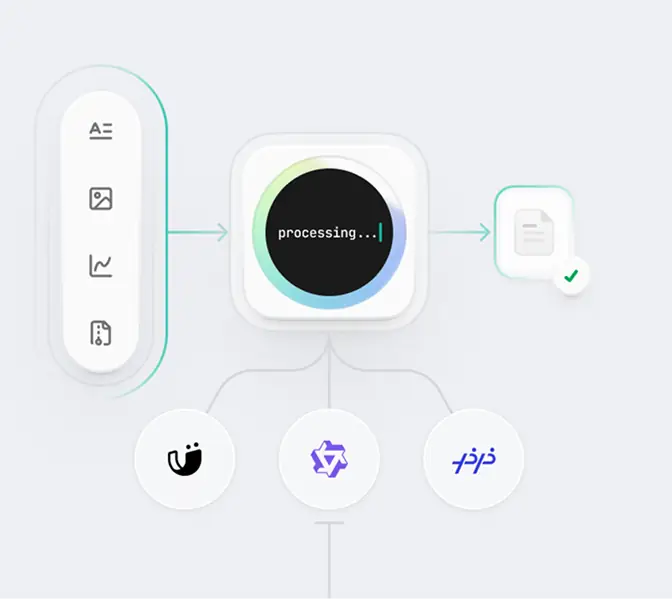
支持模型 MinerU、PaddleOCR、Qwen VL、ComfyUI,通过 AI 模型从海量数据中提取出结构化有价值的内容
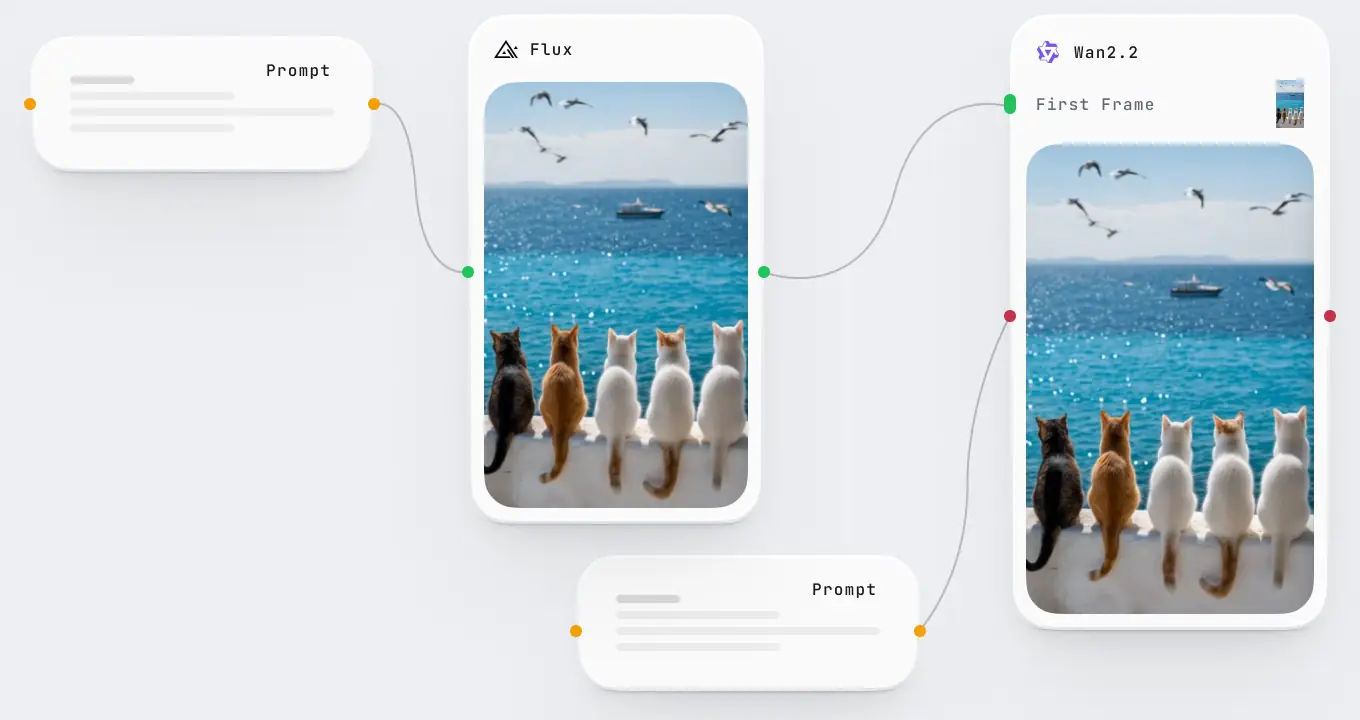
配备模型 Wan 2.2,支持文生视频、图生视频,融入精细美学数据,可生成电影级质感的视频
基于 vLLM、SGLang、Ollama 框架,和时下最新的开源大模型 GPT OSS、Qwen 进行推理,实现文本内容输出
峰值算力零排队
按需付费,随时扩缩容节点数
充沛算卡,为您的业务提供强劲动力
各平台 RTX 4090/24 GB 分时比价为例
生产级 SLA,保障业务稳定与数据安全
镜像一键上传,服务即刻就位
LIVE · 平台实时运行数据
弹性调度引擎 7×24 运行,以下为平台运行的实时视图。
LIVE·弹性调度引擎 · 实时数据流
REALTIME · 实时
调用量 · 今日—
调用率—
当前吞吐—
消耗金额 · 近1min—
可用性 · 近1min—
24H · 近24小时
调用成功率—
调用失败率—
缓存命中率—
活跃渠道—
SIMULATED FEED · 演示数据流
弹性扩缩容,自如应对业务流量波动,告别资源浪费与排队,0「空闲成本」
适用于生产服务、突发流量、在线用户访问等情况
智能批量计算,支持任务优先级 & 自动队列管理,确保关键任务优先获得资源,大幅提升业务处理效率
适用于大规模数据处理、离线渲染、定时任务队列等场景
一键接入主流大模型,完美兼容标准接口,SLA 质量保障,实现业务无缝迁移。
纯动态按量计费,无订阅费,无时间限制,以极致性价比赋能您的 AI 业务负载。
云端 AI 开发工作站,完整开发环境随时随地 coding
适用于开发测试、学习训练、长期项目
短租独占物理机资源
适用于追求极致性能,需要完全避免虚拟化损耗的用户,如高端渲染、高性能计算等场景
弹性扩缩容,自如应对业务流量波动,告别资源浪费与排队,0「空闲成本」 适用于生产服务、突发流量、在线用户访问等情况
CASES · 客户案例
针对不同用户群体的专业需求,提供定制化解决方案。
「一天内交付千卡,按秒级扩缩容,太靠谱了,选你们真没错!一起加油!」
—— Remy 首席技术官 Chris
「如果要我推荐一家算力厂商,那果断是 VOLCENGING!我们用的是 4090 处理 pdf,按量计费,并发高,性价比和效率拉满,每小时能跑 400 万页」
—— 面壁智能资深数据专家 张先生
「VOLCENGING 提供稳定、高效、低成本的分时弹性算力解决方案,支撑 LibLibAI 业务高峰算力需求。」
—— LibLibAI
「我们希望有尽量多、尽量灵活的算力去调度,来支持我们的业务,VOLCENGING 很好地满足了我们的灵活租用需求。」
—— VAST 首席技术官 梁鼎
独创电网式算力调度网络,专注为算力削峰填谷
从 0 到 1 提出并构建「全球首个闲时算力调度平台」
整合全球 70 万 + 算力资源
资源充沛
接入机房
46 家
已完成调度
3,989,489 次
服务优质
深度服务大中小型团队
5,000 +
助力客户降本
50 %+
算力稳定性
99.99 %
权威认可
央视专访报道
参与承建省级、国家级算力调度平台