这次我没有只看模型页介绍,也没有只做一轮“你好”测试,而是直接对 VOLCENGING 上的 Qwopus 27B v2 端点跑了一套更完整的测试用例,想回答一个更实际的问题:
这个模型,放到真实的 OpenAI 兼容 API 和 OpenClaw 工作流里,到底好不好用?
测试端点:
BASE_URL:https://deployment-xxxx-8000.550w.linkmodel:qwopus_27b- 权重 root:
Jackrong/Qwen3.5-27B-Claude-4.6-Opus-Reasoning-Distilled-v2
公开地址:
- Hugging Face:https://huggingface.co/Jackrong/Qwen3.5-27B-Claude-4.6-Opus-Reasoning-Distilled-v2
- 魔搭:https://modelscope.cn/models/Jackrong/Qwen3.5-27B-Claude-4.6-Opus-Reasoning-Distilled
这篇文章的重点不是部署参数,而是实际体验: 哪些 case 表现很强,哪些地方会踩坑,为什么我最后更愿意把它定位成 OpenClaw 主模型,而不是一个“随便接到聊天框里就完事”的模型。
一、先说结论
如果只看这轮实测,我的结论非常明确:
- 它在复杂任务拆解、工程风险分析、工作流规划上表现很强。
- 它不适合拿“短问短答、严格格式、只读 content”的旧假设来衡量。
- 它更像一个会先思考、再给方案的主模型,特别适合 OpenClaw。
- 如果你要它直接做标准 tool calling 或 developer role,对服务端配置还有要求。
一句话总结:
Qwopus 27B v2 更适合做 OpenClaw 里的“大脑”,不太适合拿来当一个只会秒回的普通聊天模型。
二、我实际跑了哪些测试
这次批量测试覆盖了 9 类 case:
测试项 | 目标 |
| 看服务是否在线 |
| 看模型发现和 |
简短问候 | 看短问短答时是否会“想太多” |
OpenClaw 工作流规划 | 看任务拆解与流程设计能力 |
工程风险分析 | 看工程判断和优先级排序能力 |
结构化提取 | 看严格格式任务的稳定性 |
tool calling 尝试 | 看服务端是否已开启自动工具调用 |
developer role | 看接口是否接受 |
流式输出 | 看 SSE 中 |
三、稳定性没问题,但别被“短问短答”误导
先看最基础的结果:
/health返回200/v1/models返回200qwopus_27b可正常发现/v1/models上报的max_model_len是4096- 非法模型会返回
404
这说明从“服务有没有起来”这个角度看,它是正常的。
但真正值得注意的是另一件事:
当我让它做一个非常简单的问候回复时,它反而暴露出了这种 reasoning 模型的典型特点。
例如这个 case:
用户输入:“你好,请只回复一句简短问候。”
Case 详情
- 测试类型:非流式 chat completion
- 延迟:
3746ms finish_reason:lengthcontent:空reasoning:有内容
结果是:
- HTTP
200 - 延迟约
3746ms finish_reason = "length"content = null- 大部分输出落在
reasoning
它的 reasoning 开头大概是这样:
1. Analyze the Request
2. Determine the appropriate response
3. Draft options
它实际已经开始做“候选答案筛选”,只是因为这次给的 max_tokens 很小,最后把 token 花在了思考过程上,没来得及把最终问候稳定落到 content。
也就是说,哪怕只是一个“回一句你好”,它也会先认真想一遍。
这不是“模型坏了”,而是它的工作方式本来就偏 reasoning-first。 所以如果你用普通聊天模型的标准去看它,很容易得出错误结论:
“这个模型怎么连一句问候都回不好?”
更准确的说法应该是:
它不是为“极短、极快、极直接”的对话体验优化的。
四、真正让我觉得它强的,是 OpenClaw 工作流规划能力
为了更贴近实际使用,我直接给了它一个 OpenClaw 场景:
在 OpenClaw 里做一个“文章抓取、摘要、提炼行动项、发飞书”的工作流,请输出 4 步方案,并补一句最关键的工程提醒。
Case 详情
- 测试类型:非流式 chat completion
- 延迟:
11158ms finish_reason:stopcontent:完整输出reasoning:完整输出
这次结果很能说明问题:
- HTTP
200 - 延迟约
11158ms finish_reason = "stop"- 有完整
content - 也有比较详细的
reasoning
模型最终给出的 4 步方案是:
1. 数据获取:配置定时触发器或 RSS 订阅,通过 HTTP 请求节点抓取目标文章并清洗 HTML 标签。
2. 智能摘要:将清洗后的文本传入 LLM 节点,利用 Prompt 生成一段 200 字以内的核心摘要。
3. 行动提炼:再次调用 LLM 节点,基于原文内容识别并结构化输出具体的待办事项。
4. 消息推送:将摘要与行动项组装成 Markdown 格式,通过飞书 Webhook 接口发送至指定群组。
它给出的“最关键工程提醒”是:
务必在抓取节点后增加“内容清洗与空值判断”逻辑,防止因反爬失败或 HTML 解析错误导致后续 LLM 节点报错或产生幻觉。
这里可以明显看出它不是在“写一段空泛建议”,而是真的把 OpenClaw 里的节点关系想清楚了:
- 抓取节点不是只负责拉 URL,而是要承担正文清洗
- LLM 节点不是只做摘要,还要能拆出行动项
- 消息推送不是简单发文本,而是要按飞书 Markdown 组织结果
这里真正体现它强的地方,不只是结论本身,而是它在 reasoning 里会先做一轮完整的内部规划:
1. 分析需求:明确目标、功能、约束、角色
2. 拆解步骤:抓取 -> 摘要 -> 提炼行动项 -> 发送飞书
3. 草拟方案:先给出一版工作流结构
4. 优化与精简:为了满足“4 步方案”的要求再次修正输出
这其实很像一个真正的 Agent 设计过程:
- 不是直接输出答案
- 而是先理解任务边界
- 再拆步骤
- 再优化输出格式
这就是为什么我会觉得它特别适合 OpenClaw。
五、第二个高光场景:工程风险判断
我还给它测了一个更偏工程管理的题:
用户上传 PDF,系统抽取文本,摘要后写入数据库,再把结果通知到企业微信群。请指出实现这个流程时最容易被忽略的 5 个工程风险,并按优先级排序。
Case 详情
- 测试类型:非流式 chat completion
- 延迟:
15040ms finish_reason:stopcontent:完整输出reasoning:完整输出
这次结果也很稳:
- HTTP
200 - 延迟约
15040ms finish_reason = "stop"- 有完整
content - 回答结构非常清晰
它给出的前 5 项风险是:
- 任务幂等性与状态一致性
- 异常流的死信处理
- 非结构化数据的边界控制
- 敏感数据泄露
- 长耗时任务的反馈机制
这一类回答为什么有价值?
因为它不是泛泛而谈“注意稳定性”“注意异常处理”,而是能直接把问题拆成工程团队可执行的风险清单。比如它会具体提醒:
- 用唯一任务 ID 做幂等
- 设计死信队列
- 控制 PDF 文本量和 token 预算
- 做 PII 脱敏
- 给长耗时任务加进度反馈
对 OpenClaw 这种工作流型系统来说,这类能力很关键。 因为 Agent 真正要落地的时候,最大的难点往往不是“让它回答出来”,而是“让它别在工程边界上翻车”。
如果把这条 case 放到真实业务里看,它特别适合承担两种角色:
- 工作流设计阶段的“风险评审模型”
- Agent 执行前的“方案预审模型”
六、结构化提取不算强项,至少默认配置下不是
我还测了一个看上去很适合模型的场景:
从一句话里提取公司、产品、行动项,严格输出 JSON。
Case 详情
- 测试类型:非流式 chat completion
- 延迟:
7717ms finish_reason:lengthcontent:空reasoning:有内容
结果是:
- HTTP
200 - 延迟约
7717ms finish_reason = "length"content = null- 主要输出仍然在
reasoning
有意思的是,它在 reasoning 里其实已经把结构想明白了:
company = VOLCENGINGproducts = [Qwopus 27B 镜像, OpenClaw]action_items = [...]
但它没有顺利把最终 JSON 落到 content 里。
也就是说,这条 case 不是“不会抽取”,而是“会分析,但默认不一定按你要的交卷方式输出”。 这和前面的 OpenClaw 规划题刚好形成对比:
- 需要推理、拆解、规划时,它表现很好
- 需要严格格式、立即交卷时,它反而更容易把 token 花在思考上
这说明一个现实问题:
默认配置下,它更擅长“先分析”,不一定擅长“立刻按你要求的严格结构交卷”。
如果你要把它用于结构化提取,建议不要直接裸接,而是要在外面补一层:
- 更强的输出约束
- 更小的
max_tokens控制 - 或者做后处理,把
reasoning中已经出现的结构再解析出来
所以从使用定位看,它不是不能做结构化任务,而是更适合做有思考过程的任务,不是最适合做严格格式裁判题。
七、tool calling 和 developer role:能力边界也要讲清楚
这轮测试里,我还专门测了两个很多人会默认期待“应该能直接用”的能力。
1. tool calling 尝试
我传了标准的 tools 数组,请它“查询北京天气并给出建议”。
Case 详情
- 测试类型:chat completion +
tools - 延迟:
300ms - HTTP:
400
结果是:
- HTTP
400 - 错误信息明确提示:
"auto" tool choice requires --enable-auto-tool-choice and --tool-call-parser to be set这说明什么?
说明当前这个端点不是模型不会工具调用,而是服务端没有按自动工具调用所需参数完整打开。
也就是说,如果你要把它用于更标准的 function calling 场景,需要运维侧把对应开关配好。
2. developer role
我还试了一次 developer 消息角色。
Case 详情
- 测试类型:带
developerrole 的 chat completion - 延迟:
258ms - HTTP:
400
结果:
- HTTP
400 - 报错:
Unexpected message role.
这说明当前这个 OpenAI 兼容层并不接受 developer 角色消息。
这对 OpenClaw 的意义是什么?
如果你的工作流框架或者中间层会默认注入 developer role,那你就得在接入层提前做兼容转换,比如改写成 system,否则请求直接会被拒掉。
3. 流式输出(SSE)
我还单独测了一次流式输出,prompt 是:
请写一个三点式的周报模板。
Case 详情
- 测试类型:
stream: true - 首批响应延迟:约
870ms - 流式首帧:先返回空
content - 后续 token:大量
delta.reasoning
前几帧 SSE 里,最典型的形态是:
data: {\"delta\":{\"role\":\"assistant\",\"content\":\"\"}}
data: {\"delta\":{\"reasoning\":\"用户\"}}
data: {\"delta\":{\"reasoning\":\"想要\"}}
data: {\"delta\":{\"reasoning\":\"一个\"}}
这非常能说明它的输出习惯:
- 流式不是先吐最终答案
- 而是先把 reasoning 一段一段吐出来
如果你的前端或 OpenClaw 中间层把“首字速度”定义成“用户立刻看到最终答案的第一个字”,那这类模型的体验会和普通聊天模型很不一样。 但如果你的产品本来就允许展示思考过程,或者把 reasoning 当作内部过程保存,这种输出反而是有价值的。
八、为什么我最后更建议把它当 OpenClaw 主模型
把上面的测试放在一起看,结论就比较清楚了:
它强在哪
- 工作流规划强
- 任务拆解强
- 工程风险判断强
- reasoning 过程很完整
- 对复杂任务的“先想后做”能力明显
它弱在哪
- 短问短答会“想太多”
- 严格 JSON 输出不稳定
content为空的概率不低- tool calling 依赖服务端额外开关
developerrole 当前不支持
这组强弱项其实非常像一个“主模型”和“聊天模型”的区别:
- 如果你要的是秒回、格式严格、结构固定,它不是最省心的
- 如果你要的是任务拆解、工作流设计、工程判断,它反而很合适
所以在 OpenClaw 这种场景里,我会更愿意把它放在:
- 工作流编排的决策节点
- 工具调用前的判断节点
- 复杂任务的总控节点
- 编码 / 分析类 Agent 的主模型角色
而不是直接把它当一个“用户问一句,它立刻答一句”的前台聊天模型。
九、9B / 27B 到底怎么选
这轮测试虽然主角是 27B,但结合之前的接入体验,选择建议已经很明确:
如果你现在最想做的是“先接起来”
选 qwopus_9b。
因为它更像一个入口版本:
- 更轻
- 更便宜
- 冒烟更稳
- 更适合先把 OpenAI SDK、轻量 OpenClaw 工作流跑通
如果你想让模型在 OpenClaw 里真正承担“主脑”角色
选 qwopus_27b。
因为它的价值不是“更快”,而是:
- 更会拆任务
- 更会做工程判断
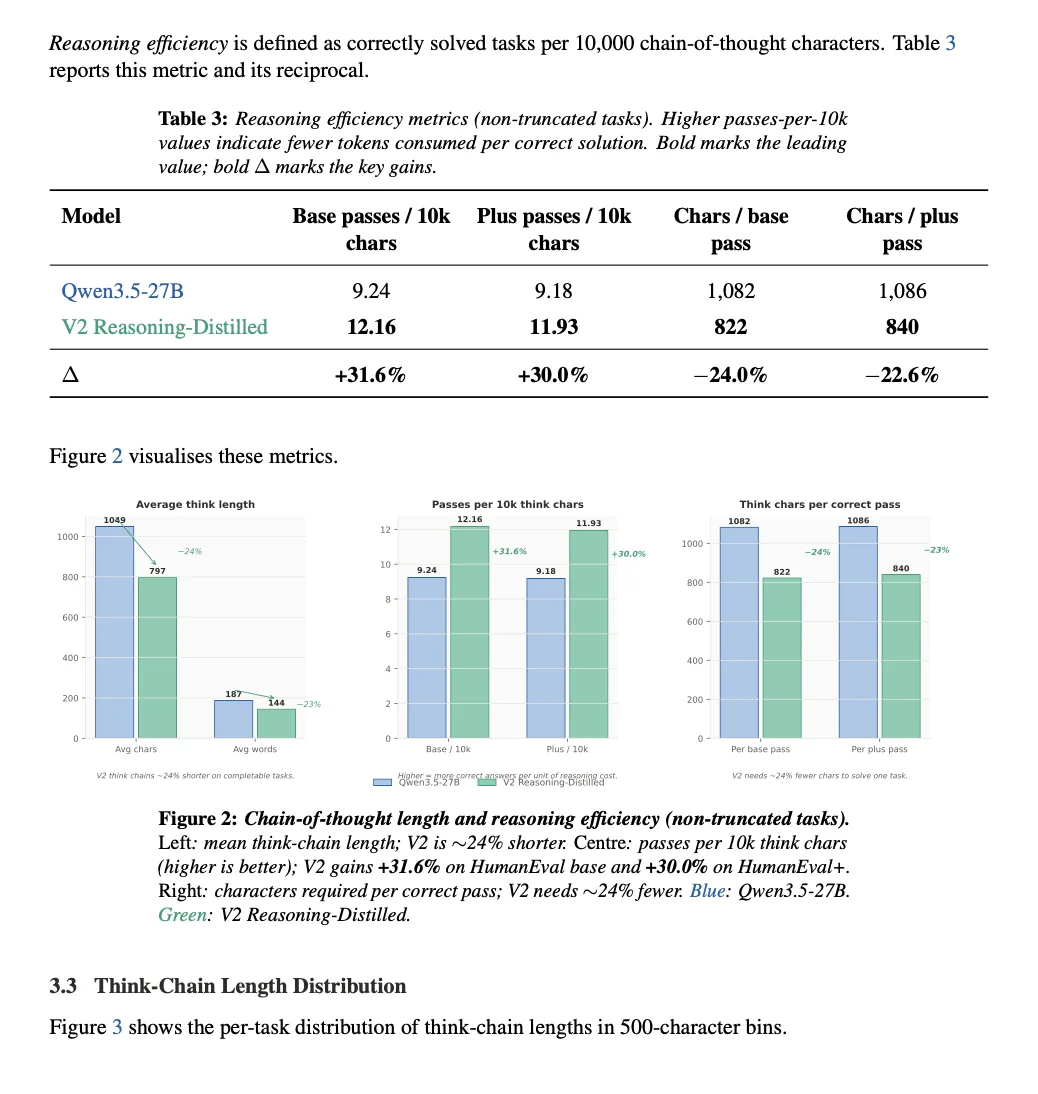
- 更像 Claude 的工作方式
- 更适合承担复杂工作流中的决策节点
一句话总结就是:
- 先试跑、先联调:
qwopus_9b - 想做更像 Claude 的 OpenClaw 主模型:
qwopus_27b
十、为什么它算 Claude 平替
“Claude 平替”如果理解成“全面替代 Claude”,那不准确。 但如果你的语境是下面这些内部场景,它确实很像一种 Claude 风格平替:
- OpenClaw
- 内部 Copilot
- 编码任务
- 分析和拆解任务
- 想要一个更低成本、随取随用的主模型
原因也很直接:
1. 成本更可控
Claude 官方 API 一旦进入:
- 高频 coding assistant
- 多轮 Agent 调度
- 长上下文分析
- 大量内部自动化任务
成本就会越来越敏感。
而如果模型直接跑在 VOLCENGING 实例上,成本结构就从“按调用量持续付费”,变成“算力资源可预估、任务可以批量消化”。
2. 随取随用
它真正的现实意义不是榜单分数,而是:
- 不用排 API 配额
- 不用担心外部服务波动
- 不用每次都把内部上下文发到外部闭源接口
对于内部工作流来说,这一点非常实际。
3. 工作方式足够像 Claude
这轮实测已经说明了:
- 遇到复杂任务,它会先思考
- 它更适合结构化推理,而不是一句话瞎答
- 放进 Agent 工作流里,它更像“会拆任务的模型”
- 配合工具调用和工作流编排时,行为更稳定
所以更准确的说法应该是:
它不是通用聊天意义上的 Claude 替代品,而是内部工作流、编码任务、Agent 执行链路里的 Claude 风格替代品。
十一、如果今天就要开始用,我的建议是什么
如果你现在就在 VOLCENGING 上准备试:
- 先用预制镜像把模型起起来
- 先接一版 OpenClaw 跑真实工作流
- 确认体验好,再考虑扩大并发和对外服务
别一上来就纠结最复杂的参数。 在这类模型上,先看它在你的工作流里顺不顺手,比先看 benchmark 更有意义。
十二、快速调用示例
curl "https://deployment-xxxx-8000.550w.link/v1/chat/completions" \
  -H "Content-Type: application/json" \
  -d '{
    "model":"qwopus_27b",
    "messages":[
      {"role":"system","content":"你是一个擅长 Agent 工作流设计的模型。"},
      {"role":"user","content":"请给我一个 OpenClaw 工作流设计方案。"}
    ],
    "max_tokens":700,
    "temperature":0.2
  }'
如果你是自己写 OpenClaw 适配层,最实用的处理方式还是:
- 优先读
choices[0].message.content - 若为空,再读
choices[0].message.reasoning - 若
finish_reason == "length",补一个“可能被截断”的兜底提示
十三、最后一句话总结
这次真实测试之后,我对它的定位更清楚了:
Qwopus 27B v2 不是那种“随便接个聊天框就能体现价值”的模型,它真正强的地方,是放进 OpenClaw 之后,像 Claude 一样承担任务拆解、工程判断和工作流决策。
如果你的目标是找一个便宜聊天模型,它未必是最优解; 但如果你的目标是给 OpenClaw、Copilot、内部智能体、代码与分析流程找一个更便宜、随取随用、工作方式更像 Claude 的主模型,那它确实很值得试。