朋友们,最近我在 Hugging Face 上发现一个名为 HuMo 的模型,它不只是能生成视频,更专注于创作高质量、可控的人物视频,而且还支持多种输入模式,彻底颠覆了以往我们对 AI 视频生成能力的认知。
核心亮点 HuMo 的超能力
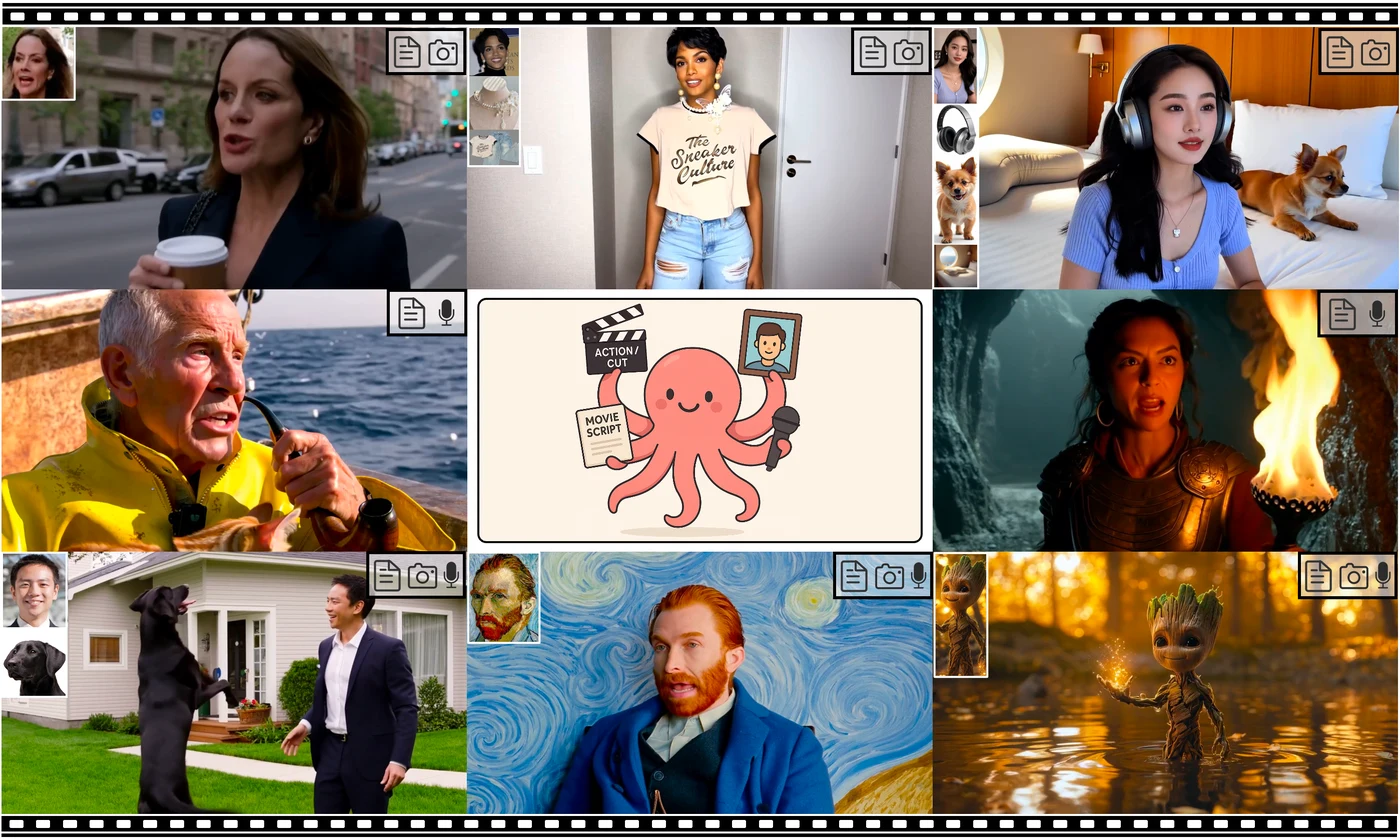
想象一下,用文字描述人物动作,用一张图锁定人物外观,再配上声音,就能生成一段人物动作与语音完美同步的视频。HuMo 正是这样的存在。它由字节跳动智能创作团队和清华大学共同开发,其目标是实现以人为本的视频生成,特别在细节、一致性、可控性方面达到了前所未有的高度。
多模态融合 创作无界限
HuMo 最让我兴奋的,是它灵活的多模态输入能力。这让视频生成不再是简单的文本到视频,而是真正意义上的多维度控制到视频。
- 文字加图像生成 想要定制特定角色的外观、服装甚至妆容,只需要提供文字描述和一张参考图。以往 AI 视频里人物变脸的问题,在这里得到了很好的解决,角色始终如一,这对于品牌内容或角色 IP 的延续性至关重要。
- 文字加音频生成 这是我个人觉得最反直觉也最酷炫的功能。它允许你仅仅通过文本和音频,就能生成与声音完美同步的人物视频。这意味着创作者无需寻找或生成图像参考,直接用声音驱动人物表演,极大地拓宽了叙事和创意空间,比如为播客、有声读物快速配上生动画面,或者纯粹通过声音指令来设计角色的表演。
- 文字加图像加音频 当然,如果你想要极致的定制和控制,可以同时输入文字、图像和音频。这种组合让视频生成的精细度达到最高,真正实现创作意图的精准落地。
轻松上手 GGUF 版本已就绪
对于咱们这些想要尝鲜的 AI 爱好者,好消息是,Kijai 发布的 HuMo FP16 模型现在有了 VeryAladeen 提供的 GGUF 量化版本。这意味着它对硬件的需求大大降低,从 2 比特到 8 比特多种选择,文件大小从 6.24 GB 到 18.3 GB 不等,让更多人有机会在本地设备上跑起来,亲身体验 HuMo 的魅力。
HuMo 模型官方 Hugging Face 页面:
https://huggingface.co/bytedance-research/HuMo
GGUF 量化版本下载页面:
https://huggingface.co/VeryAladeen/Wan2_1-HuMo_17B-GGUF
小绩思考
我一直认为,AI 生成视频的瓶颈之一就是人物的稳定性和可控性。胡子拉碴的大叔在下一帧突然变成小鲜肉,这种惊喜对创作者来说是灾难。
HuMo 把重心放在人身上,并用多模态输入来精确控制,这不只是技术进步,更是内容创作思维上的一个转变。它让我们从生成一段视频转向定制一个人物在视频里表演,大大提升了视频内容的商业和艺术价值。未来,我们或许能看到更多基于这类模型的虚拟主播、数字人助手,甚至影视预演,而不再受限于昂贵的 3D 建模和渲染。这对于独立创作者来说,无疑是开启了一个全新的时代。